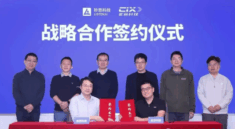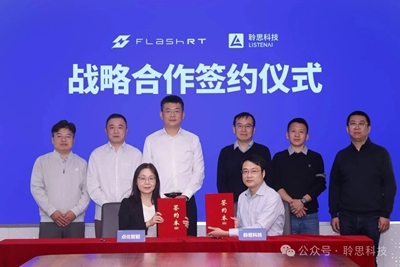
10月23日,聆思科技与点化智能科技在北京举行战略签约仪式。
聆思科技CEO王智国,点化智能科技CEO鲁力带队参与仪式;聆思科技市场副总裁韩超阳和点化智能科技生态合作总监王斌共同签署战略合作协议;聆思科技执行总裁王海坤、副总裁徐燕松,点化智能科技联合创始人李晓唯,共同见证签约仪式。
双方将发挥聆思端侧大模型推理芯片与点化智能科技FlashRT端侧推理引擎的优势,提升具身大模型在端侧芯片上的执行效率、运行性能和应用适配能力,为全球具身智能产业提供高效、可复用、可规模化落地的端侧推理解决方案。此次合作标志着具身智能产业正从单一模型或单颗芯片的性能比拼,进入模型、推理引擎与芯片协同定义系统效率的新阶段,推动具身大模型从算法能力走向产品能力,加速具身智能软硬件体系的产业化进程。
具身智能进入真实作业阶段,深度协同成为产业化关键
当前,具身智能正从实验室和展厅走向实训场与实景场,产业竞争也正在从样机参数比拼,转向真实场景下的连续作业能力。对于机器人而言,真正进入生产、物流、巡检、教育和家庭等场景,除了要具备感知、理解和行动能力,还要在复杂环境中保持稳定运行,并满足实时响应、低功耗和长期可靠等要求,这些要求决定了具身智能的计算必须向端侧下沉。
而端侧要想持续稳定高效的承载大模型,需要底层芯片、模型与基础设施平台之间的深度协同。与此同时,具身模型的算法能力和多模态能力快速提升,但模型迭代越快,对端侧部署效率的要求也越高。本质上,行业面对的是M家模型或机器人企业与N款端侧芯片之间的M×N适配关系。传统开发模式下,每一款新模型落地到每一款新芯片,都需要重新进行编译、算子适配、性能调优和流水线调试,模型或芯片一旦更新,整套工作还要重复开展。
这种模式周期长、投入大、重复性高,高度依赖专业底层工程团队,导致行业中优秀的算法模型很多,但真正能够高效迁移、稳定运行并进入量产的具身智能方案仍然有限。如何持续、稳定、高效的进行端侧大模型推理,如何提升模型跨芯片部署和持续优化的效率,已经成为具身智能产业化必须解决的关键问题。
芯片引擎深度适配联调,具身智能加速落地
针对具身智能对实时响应、持续运行和低功耗推理的要求,聆思科技长期从AI算法需求出发定义端侧芯片,以AI原生NPU为核心,构建覆盖芯片、算法、方案和工具的端侧推理技术体系。
面向机器人等物理AI终端,聆思端侧大模型推理芯片针对Transformer类模型的计算和访存特征进行架构与算子优化,并通过高带宽存储设计提升大模型推理过程中的数据吞吐能力,在有限功耗和设备体积下兼顾推理性能与运行效率。
目前,聆思新一代NPU芯片可支持双芯片级联可运行27B的稠密模型,7B 模型Decode速度达到100tokens/s,典型功耗控制在5至15W,能够为机器人端侧提供高性能、低功耗、低延迟的本地推理能力,支撑具身智能终端完成环境感知、指令理解和任务决策等大模型应用。
在模型部署方面,点化智能科技依托FlashRT端侧推理引擎开源社区设立,聚焦解决具身模型及AIPC等端侧应用场景与端侧芯片之间的适配难题。
FlashRT可根据模型参数及目标芯片的算力、算子等参数,实现具身大模型的秒级自动部署,并以连接多种模型与多种芯片的M×N范式,将模型适配、编译优化、运行调度和性能调优转化为可复用的推理基础设施。此次签署战略协议,聆思科技与点化智能科技将重点聚焦具身智能大模型及其真实应用负载,推进 FlashRT推理引擎与聆思端侧大模型AI推理芯片、编译器、运行时、算子库和软件开发工具链的适配联调,协同开展模型迁移、部署、性能优化和能效调优。
围绕具身智能领域的端侧大模型推理需求,聚焦机器人视觉、语音交互、运动控制等典型应用场景,打造软硬件一体化解决方案;同时,双方合作将同步覆盖AIPC本地大模型助手、多模态交互、边缘计算平台等应用场景,联合推出开发套件、参考设计和行业样板,帮助客户快速完成相关产品的原型验证与量产落地。
从单点性能到系统效率,协同链路定义行业新范式
放在具身智能产业的发展进程中看,这次合作的意义不只是完成推理引擎与端侧芯片之间的技术适配,更体现了产业协作方式的变化:芯片企业开始从真实模型和应用需求出发完善硬件能力,推理引擎也不再停留在单一项目的软件部署,而是与芯片平台共同推进性能优化、工具建设和方案落地。
当端侧AI芯片、推理引擎、开发工具和具身智能应用逐步形成协同体系,具身智能产业的竞争就将不再局限于单一模型效果或单颗芯片参数,而是转向对系统效率、部署能力和真实运行表现的综合竞争。聆思科技与点化智能科技的合作,将为具身大模型建立从算法、引擎、芯片到终端应用的协同链路,也为国产具身智能产业形成自主、可复用、可持续演进的软硬件基础设施提供新的实践。